
وحدة تبديل حالة النص
الملخص
محرك عالمي لتكبير الحروف وضبط النصوص متعدد أنظمة الكتابة
حل ذكاء إملائي مخصص للمؤسسات، صُمم لتنفيذ عمليات تحويل حالة الأحرف وقواعد تكبير الحروف المعقدة وفائقة الدقة عبر أنظمة كتابة عالمية متباينة وأنظمة كتابة غير لاتينية.
الشاشة

الشاشة
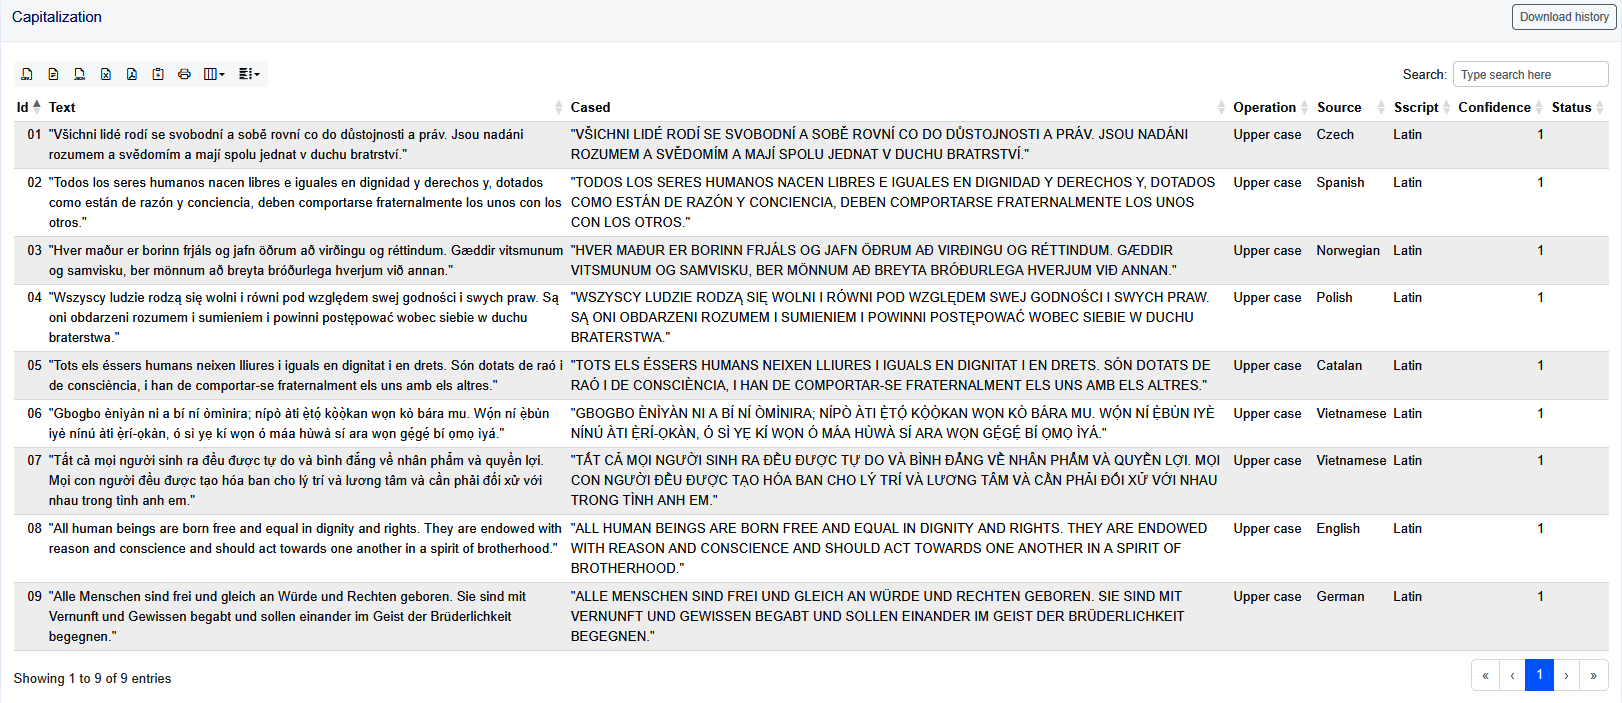
 الصفحة الرئيسية للمعالج
الميزات
دعم الأنظمة الإملائية: يشغل خوارزميات متطورة لحالة الأحرف مصمم خصيصاً للتعامل مع بنى تكبير الحروف المعقدة غير اللاتينية واللاتينية المستهدفة بسلاسة.
بصمة لغوية هائلة: يعالج تنوعات النصوص عبر 150 لغة و200 دولة، مع معايرة عميقة للهجات تشمل 33 تنوعاً لغوياً متميزاً.
مسارات دقيقة لتبديل حالة النصوص: يركب ويطابق سجلات النصوص العالمية باستخدام مسارات تحليل إملائي متزامنة للحفاظ على نصوص العلم وقواعد النحو المحلية.
ذكاء أنظمة الكتابة دون تدخل بشري: تقنيات معالجة اللغة الطبيعية (NLP) المتكاملة توفر كشفاً تلقائياً فورياً عن اللغة، مما يلغي الفرز المسبق اليدوي للنصوص وتدفقات البيانات متعددة أنظمة الكتابة.
استيعاب لمختلف أنماط البيانات: يحلل النصوص الخام المتتابعة بسلاسة من 4 صيغ إدخال ذكية، متوافقاً مع القوائم الرأسية بالإضافة إلى القيم المفصولة بفاصلة، فاصلة منقوطة، ومسافة.
التحكم في مخرجات البيانات: يصدر صحائف البيانات النظيفة والمنظمة إلى 5 صيغ أساسية (CSV, JSON, XLSX, PDF) مع إمكانية البحث الحي الفوري على مستوى واجهة المستخدم، التصفية، الفرز، الطباعة، النسخ، الإخفاء، وإعادة ترتيب الأعمدة.
بنية تحتية جاهزة للبيئات التشغيلية والإنتاجية: يتكامل مع مسارات تنظيف البيانات عالية السرعة أو مسارات العمل البشرية عبر واجهة برمجية REST API قابلة للتوسع أو واجهة مستخدم رسومية (GUI) بديهية.